
课程简介
Agentic AI时代,有好的算力只是最基本的需求,如何优化算力集群,把有限的算力充分利用起来,才是token经济学的关键要素,其核心指标无疑是TTFT和TPOT,围绕着这个目标,我们不仅需要使用上文提到的推理框架,还需要配套的传输,存储,路由,调度等一整套生产方案,才能让产出覆盖成本,实现盈利。
目前国内算力的消费主体已经从训练转向了推理,在模型越来越大,算力规格也越来越高的情况下,使用推理引擎优化推理任务已经成为了生产必备的要素,而今天这个领域的技术已经逐渐收敛成两个主流推理框架——vllm与sgLang。
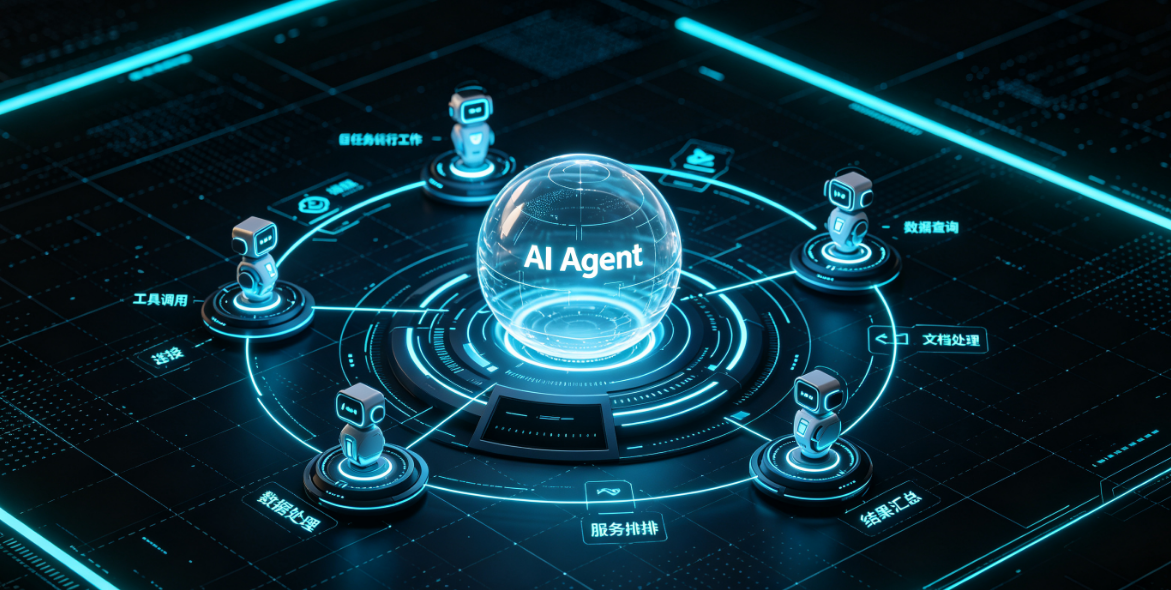
本次分享围绕提升vLLM集群的算力利用率展开,深入浅出为与会者解析vLLM推理集群优化的三个阶段。
一、粗放式部署:vLLM 被当作普通工作负载来部署,没有 PD 分离,也没有智能路由。GPU 算力占用虚高却利用不充分,TTFT 和 TPOT 表现均不理想。
二、架构优化:引入 llm-d,通过 KV Cache 分层管理、PD 分离和 Prompt 路由,大幅提升了系统吞吐量。但 GPU 仍是单实例独占使用,小参数量模型场景下算力利用率依然不足。
三、算力充分释放:在 llm-d 基础上引入 虚拟化技术,实现 GPU 的精细切分与多模型共享,每张GPU得以充分利用,实现效率与延迟的双重优化。
让与会者掌握用技术手段将GPU算力转化为成本竞争力、服务质量和商业敏捷性的能力。
课程收益
目标:
1、围绕推理框架,阐述每一个推理优化的出发点和效果,以此帮助企业梳理清楚这其中错综复杂的技术关联,从而可以从自身的实际出发,选择适合自己的技术选型。
2、绝大多数大模型推理任务都依赖于 vLLM 或 SGLang 等推理框架。在实际落地生产的过程中,厘清其衍生的诸多概念,如 LWS(LeaderWorkerSet)、PD 分离(Prefill-Decode Disaggregation)、KV Cache、缓存命中率等;同时,在 vLLM/SGLang 的外围生态中,也涌现出了大量开源项目,如 Mooncake、KTransformers、llm-d、Dynamo 等,帮助与会者更好的应用。
成功要点:
1、vLLM推理集群优化的价值直接体现在降本、增效和提升体验上。从推理成本上看,vLLM的PagedAttention技术可将KV缓存内存浪费从60-80%降至接近零。若 Stripe从Hugging Face Transformers迁移到vLLM后,成本下降73%,只用1/3的GPU就可处理日均5000万次API调用。
2、vLLM相比传统框架可提供2-24倍的吞吐量提升,优化用户体验,低TTFT带来“秒回”感,低TPOT确保长文本生成流畅。独立优化能更好控制尾部延迟(Tail Latency),保障SLA。
3、在代码任务上可将每百万输出token成本降低19.4%,意味着增强系统弹性与资源利用率中,可根据流量高峰独立扩展P或D节点,并为不同阶段选择最大化GPU利用率。
启示:
企业掌握vLLM集群优化,本质上是掌握了用技术手段将GPU算力转化为成本竞争力、服务质量和商业敏捷性的能力。
受众人群
大模型开发工程师、技术专家、架构师、中台研发人员、端云研究人员、CTO、算法工程师、AI工程师以及其他对架构感兴趣的从业者。
课程周期
0.5天(3H)
课程大纲
授课内容 |
一、vLLM的基础使用方式 |
二、vLLM与云原生的组合方式 |
三、vLLM + KVCache/PD分离的技术出发点和效果 |
四、vLLM + KVCache/PD分离+GPU虚拟化的组合实践 |


 京ICP备2022035414号-1